 CLOUD云枢
别再用旗舰模型跑日常简单任务了。
阿里百炼上了新模型:deepseek-v4.1-flash。
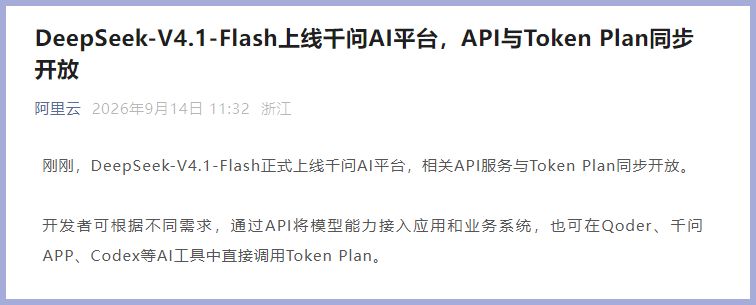
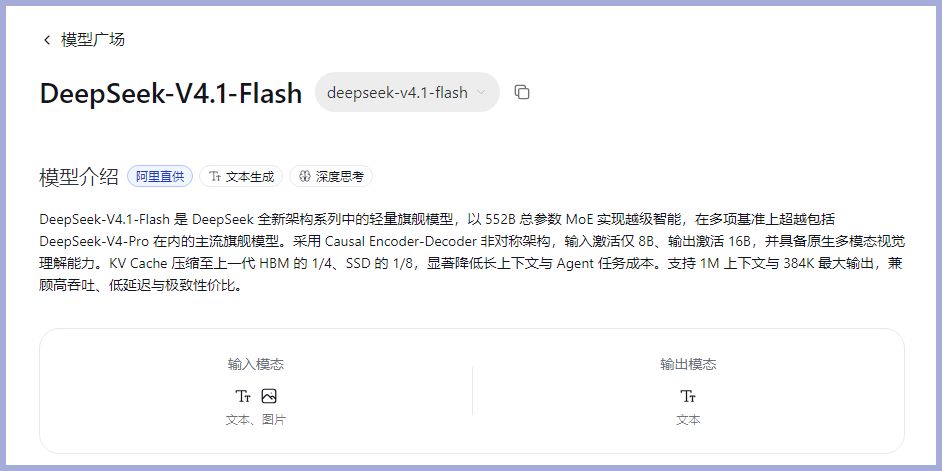
这个模型有意思。轻量旗舰,552B总参数MoE,原生支持视觉理解,1M上下文,384K最大输出。能力不差,价格很香。
阿里云百炼 Token Plan 订阅: https://www.aliyun.com/minisite/goods
阿里云Qoder CN 个人版Pro版与企业版订阅: https://www.aliyun.com/minisite/goods
阿里百炼平台API Key: https://bailian.console.aliyun.com/cn-beijing/model/settings/api-key
阿里云百炼控制台模型广场: https://bailian.console.aliyun.com
但今天不聊参数,聊点实际的:怎么让你的Token Plan额度更耐用。
用过阿里Token Plan的朋友应该都有体会。Lite套餐7天只有2500 Credits,Standard是10000,Pro是40000。看着不少,用起来飞快。
有些人一两天就把额度耗完了,剩下的日子要么歇菜,要么掏钱买用量包。
问题出在哪?
大多数人用错了模型。
别拿牛刀杀鸡:日常任务就该用Flash
Token Plan的Credits消耗,和调用的模型价格直接挂钩。
你用的是qwen3.8-max还是deepseek-v4.1-flash,同样的任务,消耗能差好几倍。
举个例子。qwen3.8-max的输出价格是36元/百万token(原价)。而deepseek-v4.1-flash的输出价格,闲时大约4元,忙时大约8元,和DeepSeek官网的峰谷定价一致。
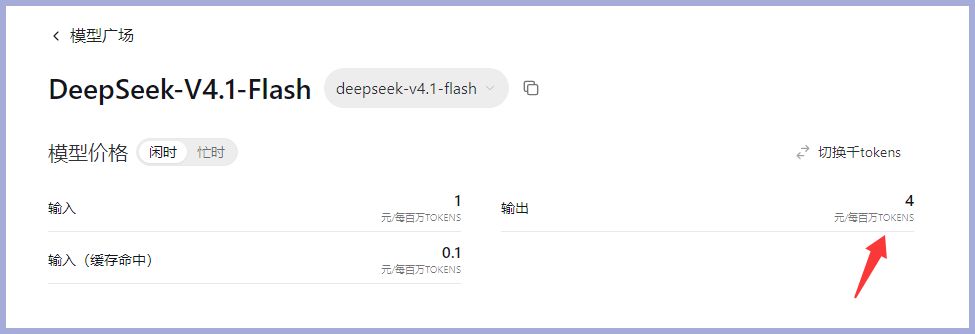
价格差了4到9倍。
什么意思?你用一次qwen3.8-max的Credits,够你用deepseek-v4.1-flash跑好几轮。
大多数日常任务——写代码、改bug、解释逻辑、写文档——flash模型完全够用。
阿里百炼自己的文档也建议:确认效果满足需求后,尝试用flash模型来降低成本,效果接近旗舰模型,上下文和功能支持也一样。
真正需要qwen3.8-max的场景是什么?复杂数据分析、多步逻辑推演、最强推理能力。这类任务不多。
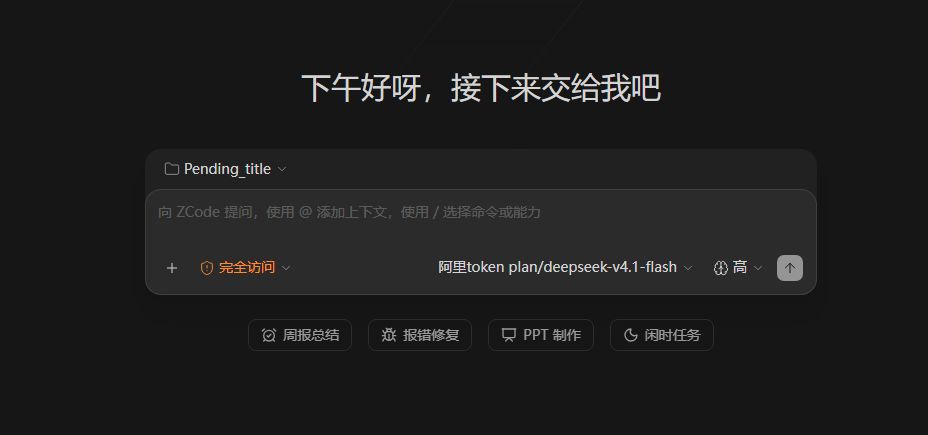
所以第一条省钱技巧很简单:把默认模型换成flash。 只在真正需要的时候,手动切回max。
让模型闭嘴:减少废话输出
Token Plan的Credits消耗,输出Token占大头,而输出是最贵的。
为什么?因为输出价格通常比输入贵得多。deepseek-v4.1-flash的输出价格是输入的4倍。
模型每多说一句废话,你的额度就多烧一分。
大模型有个通病:话多。
问个简单问题,它先来一句“好的,我来为您解答”,中间分“首先、其次、最后”,结尾还要加“希望这个回答对您有帮助”。这些都是白花花的Credits。
怎么治?用Prompt强制约束。
几个有效的写法:
“你是一个惜字如金的专家。禁止寒暄、禁止过渡句、禁止总结,直说重点。”
“只输出代码。不要解释。不要Markdown代码块标记。”
“严格以JSON返回。不要任何JSON之外的文本。”
实测有效。特别是写代码的时候,一句“只输出代码本身”,能省掉大量解释性废话。
还有几个实用技巧
压缩历史对话。 长对话的上下文会累积消耗。没必要每次都把前面几十轮对话全带上。定期新开对话窗口,或者手动压缩历史消息。
用好缓存。 百炼支持上下文缓存。缓存命中的输入Token,计费价格远低于正常输入。如果你有反复使用的System Prompt或固定指令,尽量利用缓存机制。
关闭思考模式。 有些任务不需要模型“深度思考”。思考模式会产生额外的推理Token消耗。简单任务关掉它。
别在高峰期跑批量任务。 deepseek-v4.1-flash实行峰谷定价。高峰时段是北京时间9:00-12:00和14:00-18:00,价格翻倍。空闲时段价格是高峰的一半。批量任务放到晚上或午休时间跑,成本立省一半。
设置stop参数。 如果你是开发者,在API调用时设置stop序列。比如提取信息时,让模型输出完就停,别让它继续“总结一下”。
查看用量分析。 百炼控制台有用量分析页面,能看到Credits消耗明细。定期看看哪些模型、哪些任务消耗最大,针对性调整。
总结
Token Plan的额度不够用,很多时候不是额度太少,是用法太浪费。
把默认模型换成deepseek-v4.1-flash,日常任务成本直接降几倍。用Prompt管住模型的嘴,输出Token省一大截。再配合缓存、峰谷调度、历史压缩,你的额度耐用程度能上一个台阶。
省额度不是抠门,是把资源花在真正需要的地方。
Token Plan:https://t.aliyun.com/U/T0RY8t